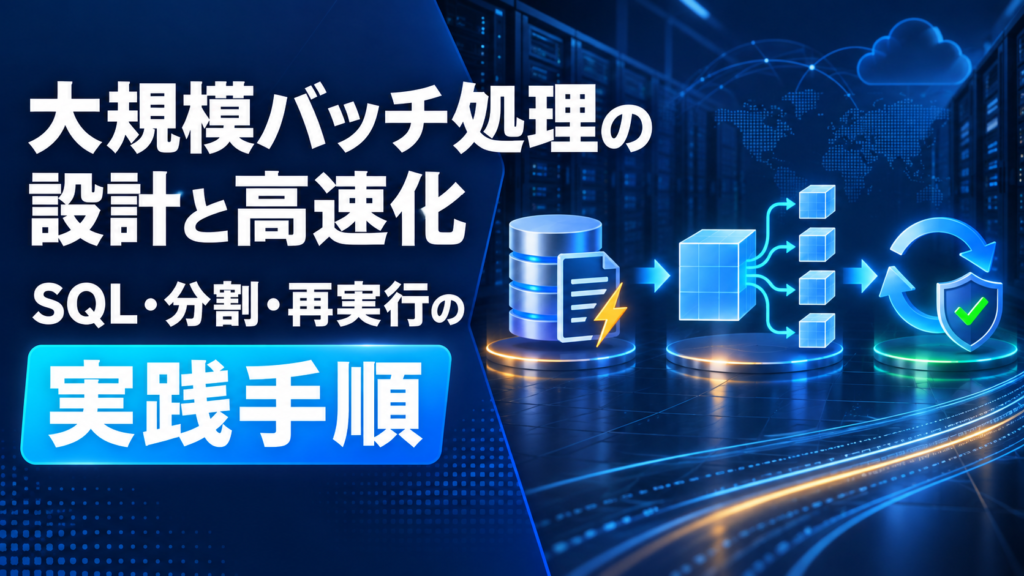
大規模バッチ処理の設計と高速化|SQL・分割・再実行の実践手順
 株式会社 SunSunTech
数百万〜数千万件のデータを扱うバッチ処理で、「時間内に終わらない」「途中で失敗すると最初からやり直しになる」「本番データが増えた途端に遅くなった」と悩む開発者は少なくありません。大規模バッチの改善では、SQLだけを速くするのではなく、処理時間の目標、データ分割、並列度、再実行、監視までを一体で設計する必要があります。本記事では、バックエンド開発者や運用担当者に向けて、ボトルネックの見つけ方からSQL改善、失敗に強い実行方式まで、実務で使える手順を解説します。
目次
大規模バッチ処理で最初に決める性能目標
改善を始める前に、「何件を何分で処理できれば合格か」を数値で定義します。単に高速化するという目標では、改善の終了条件も安全な並列度も決められません。まず次の項目を整理しましょう。
- 通常日と繁忙日の対象件数、1日あたりの増加率
- 処理開始時刻、完了期限、後続処理の開始条件
- 許容できるCPU、メモリ、DB接続数、I/O負荷
- オンライン処理と重なる時間帯、その時間帯の性能制約
- 失敗時に復旧へ使える時間と再処理できる範囲
次に、処理全体を「抽出」「変換」「外部連携」「書き込み」「後処理」に分け、各区間の実行時間と処理件数を記録します。アプリケーションのログだけで判断せず、DBの実行計画、スロークエリ、CPU使用率、ディスクI/O、ロック待ちも同じ時刻軸で確認します。遅さの原因がSQLなのか、ネットワークなのか、外部APIなのかを切り分けるためです。
計測は本番相当のデータ量と偏りで行うことが重要です。少量データでは効いていたインデックスが、大量データでは全件走査より遅くなる場合があります。平均値だけでなく、最大処理時間や処理件数の偏りも確認し、「どの条件で遅くなるか」を再現できる状態にします。
SQLとインデックスを改善する手順
SQL改善では、推測でインデックスを追加せず、実行計画から読み取ります。対象行数、実際に読み取った行数、結合順序、ソートや一時領域の使用、インデックスの選択を確認し、絞り込み条件に対して過剰な読み取りが発生している箇所を特定します。
- 必要な列だけ取得する:「SELECT *」を避け、転送量とメモリ使用量を抑えます。
- 早い段階で絞り込む:期間、状態、主キー範囲などで対象を限定してから結合します。
- 複合インデックスを設計する:等価条件、範囲条件、並び順を踏まえ、頻出SQLに合う列順を選びます。
- 関数適用を見直す:検索列への関数や暗黙の型変換がインデックス利用を妨げていないか確認します。
- 一括更新を小分けにする:巨大なトランザクションを避け、ロック時間とログ量を抑えます。
インデックスは読み取りを速くする一方、更新コストと容量を増やします。追加後は対象SQLだけでなく、登録・更新処理への影響も測定してください。また、同じ結果を複数回取得する場合は、途中結果を一時テーブルに保持する方法も有効です。ただし、作成・削除の費用や障害時の残存データまで含めて評価します。
データ分割と並列化を安全に設計する
1回で全件を処理する構成は、データ増加に弱く、失敗時のやり直しも大きくなります。主キー範囲、日付、顧客IDのハッシュ値など、重複せず漏れないキーでデータをチャンクに分けます。各チャンクの開始・終了位置、件数、状態、実行時刻を管理テーブルへ記録すると、進捗確認と部分再実行が容易になります。
チャンク件数は固定値で決め打ちせず、1チャンクの処理時間、コミット時間、メモリ量から調整します。小さすぎると起動やコミットのオーバーヘッドが増え、大きすぎるとロックと再実行の負担が増えます。まずは1チャンクが数分以内に終わる大きさから検証し、実測で最適化すると安全です。
並列化では、ワーカー数を増やせば比例して速くなるとは限りません。DB接続、ディスクI/O、外部APIの上限を共有するため、一定数を超えると競合で遅くなります。1、2、4ワーカーのように段階的に増やし、全体時間とDB負荷を比較します。特定のキーにデータが集中する場合は、単純な範囲分割では一部のワーカーだけが遅れるため、件数が均等になる分割方法を選びましょう。
失敗に強い再実行・監視の仕組みを作る
大規模バッチでは、失敗しないことより「失敗しても安全に続きから処理できること」が重要です。同じチャンクを再実行しても結果が二重にならないよう、処理を冪等に設計します。登録前に処理済みキーを確認する、更新前後の状態を条件に含める、外部送信には一意なリクエストIDを付ける、といった方法があります。
管理テーブルには、ジョブID、チャンクID、対象範囲、状態、試行回数、開始・終了時刻、処理件数、エラー概要を記録します。再実行は「失敗したチャンクだけ」を対象にし、実行中のチャンクと重複しない排他制御を設けます。例外を握りつぶして成功扱いにせず、処理件数の期待値と実績値も突き合わせてください。
監視では、成功・失敗だけでなく、次の予兆を検知します。
- 処理速度が基準値を下回った
- 未処理件数が想定より増えている
- リトライ回数やエラー率が上昇した
- 特定チャンクだけ処理時間が長い
- 完了見込み時刻が期限を超える
リリース時は、旧処理へ戻す条件と手順も決めます。新旧の件数・集計値を比較できる期間を設け、差分が許容範囲を超えたら停止する判断基準を明文化しておくと、性能改善によるデータ不整合を防げます。
大規模バッチ処理に関するFAQ
Q1. SQL改善と並列化はどちらから始めるべきですか?
先に計測し、不要な全件走査や過剰な読み取りを減らします。非効率なSQLのまま並列化すると、DB負荷とロック競合が増える恐れがあります。単体処理を改善した後に、余力を確認しながら並列度を上げる順序が安全です。
Q2. バッチのチャンクサイズは何件が適切ですか?
一律の正解はありません。1件あたりの処理量、行サイズ、コミット時間、失敗時の再処理時間で変わります。本番相当データで複数サイズを測り、処理時間と負荷が安定する値を選びます。
Q3. 本番でしか性能問題が再現しない場合はどうしますか?
個人情報を除いた統計的に近いデータを用意し、件数だけでなく値の偏りや重複率も再現します。本番ではクエリ時間、読み取り行数、待機時間など影響の小さい計測から始め、変更は小さく段階的に適用します。
まとめ
大規模バッチ処理の高速化は、SQLの書き換えだけでは完結しません。まず性能目標を決めて区間別に計測し、SQLとインデックスを改善したうえで、データ分割と並列度を調整します。さらに、チャンク単位の再実行、冪等性、進捗監視、切り戻しまで設計することで、データ量が増えても安定して運用できる仕組みになります。最初の一歩として、現在の処理を工程別に分け、各工程の時間・件数・DB負荷を1回分記録してください。最も時間を使っている区間が、改善の優先順位です。
投稿者プロフィール
-
はじめまして。
株式会社SunSunTech代表取締役の鈴木と申します。
SunSunTechは、エンジニアが納得できるキャリアと報酬を得られるSES企業を目指して設立しました。
私は元々、エンジニアとして複数のSES現場で経験を積んできました。
その中で、「スキルに見合った評価が得られない」「給与の仕組みが不透明」といった業界特有の課題に何度も直面してきました。
こうした状況を変えるために、SunSunTechでは、透明性のある評価制度の導入、エンジニアファーストな案件選定など、"エンジニアが報われる仕組み"を徹底しています。
SES企業様とのパートナー連携においても、スピード・誠実・精度を大切にし、長期的に信頼される関係構築を目指しております。
エンジニアの未来を、本気で変えていく。
その想いに共感してくださる方、ぜひ一度お気軽にお声がけください。
最新の投稿
 その他IT案件2026年9月18日ADRの書き方|技術選定の理由を残すテンプレートと運用ルール
 その他IT案件2026年9月17日受入テスト(UAT)の進め方|計画・シナリオ・判定基準の実践手順
 その他IT案件2026年9月17日大規模バッチ処理の設計と高速化|SQL・分割・再実行の実践手順
 PM・PMO2026年9月16日プロジェクト課題管理表の作り方|項目・優先順位・運用ルールを実践解説